lunes, 31 de octubre de 2011

Sistemas que recuperan información

Cualquier información invita a los usuarios dotar de instrumentos de consulta, navegación y recuperación de información adecuados para satisfacer las necesidades de información. Sin embargo, existe una gran explosión documental y no sabemos cuál de éste gran volumen de documentos e información es útil y se pueda recuperar de una forma más fácil y que cumpla con unos ciertos requisitos durante su búsqueda.

Existe gran variedad de herramientas que permitan hacer búsquedas de información que sean efectivas y que contengan conocimiento intelectual, válido para la investigación y el aprendizaje; estas herramientas se resumen en cuatro siglas o en el mejor de los casos, en cuatro palabras: Sistemas Gestores de Bases de Datos – SGBD.

Estas herramientas se dividen en tres fases, por medio de las cuales permiten y facilitan el acceso y la recuperación de la información:

1- Sistemas de navegación de tipo jerárquico: este sistema permite estructurar jerárquicamente a información: clases y subclases, y es aquí donde el usuario decide qué opción se ajusta a las necesidades de información(ejemplo:www.yahoo.com)

2- Sistemas de navegación hipertextuales: Sistema de búsqueda permite que el usuario vaya de un documento a otro con solo dar un click al activarse los vínculos estipulados en el mismo para tal fin.

Por otra parte, el documento hipertextual está formado por bloques o partes que se interrelacionan entre sí, con un orden establecido que permita re permita recorrer diversas direcciones web.

3- Sistemas de recuperación de información: aquí no se emplea la búsqueda a través de navegadores, sino que este tipo de búsqueda se hace por medio de un conjunto de operadores y también  instrucciones específicas que hacen posible efectuar la búsqueda de información más detallada y relevante.

La base de la recuperación de información en los sistemas informáticos se emplea el uso de álgebra booleana o también llamadas ecuaciones de búsqueda, en donde se hace combinaciones de búsqueda de términos o documentos mediante los operadores de unión, intersección y negación.

Publicado por: Myriam Gil

domingo, 30 de octubre de 2011

Metadata : combining content-based and metadata-based approaches

Autor
DAY, Michael
Titulo
Metadata : combining content-based and metadata-based approaches
Fuente
Report from the Second UK Conference on Image Retrieval held in Newcastle on the 25-26 February 1999
Soporte
Resumen
Estudia la recuperación de imágenes en la WWW basada en el contenido.
P. Clave
imagen; recuperación; world wide web; metadatos

Introduction
"Image[1]-based information is a key component of human progress in a number of distinct subject domains and digital image retrieval is a fast-growing research area with regard to both still and moving images. In order to address some relevant issues the Second UK Conference on Image Retrieval - the Challenge of Image Retrieval (CIR 99) was held in Newcastle upon Tyne on the 25 and 26 February 1999 [1]. Participants included both researchers and practitioners in the area of image retrieval".


The Tyne Bridge, Newcastle upon Tyne[2].


[1] CIBERABSTRACS. Directorio de recursos sobre el resumen. María Pinto. Consulta en línea: http://www.mariapinto.es/ciberabstracts/recumeta.php?pagina=2&criterio=recumeta

domingo, 23 de octubre de 2011

TUTORIAL GOOGLE DESKTOP

1.     Se procede en primera estancia ingresar al sitio www.google.com


2.     Se procede a acceder al sitio sugerido por el Navegador para realizar el proceso.


3.     Se acepta un término de licencia acerca del uso de dicha herramienta.


4. Se procede a guardar el archivo en la carpeta de descargas del equipo de trabajo.


5.  Se ejecuta la aplicación de acuerdo a la descarga realizada.


6. La aplicación muestra en pantalla las funciones de la aplicación que se van a cumplir en el momento de la instalación de la aplicación en el equipo.


7. Se determinan las preferencias acerca de que necesito como usuario para que funcione la aplicación.


Configuración
Para realizar la configuración de la aplicación para poder realizar el proceso de indexación se procede al costado derecho de la pantalla para determinar que opciones se requieren para poder hacer uso de la herramienta.


Se procede a configurar las opciones que muestra la aplicación para continuar con el uso de la herramienta


Posteriormente se procede a determinar las carpetas que se van a utilizar para realizar el proceso de indexación.


Después de haber seleccionado los archivos donde se desea realizar las búsquedas, se procede a guardar las preferencias de las referencias que se encuentran tanto en la parte inferior como en la parte superior de la página.


Publicado por: Myriam Gil

jueves, 20 de octubre de 2011

Tutorial Archivarius 3000

Archivarius 3000 – es una aplicación completa para buscar documentos y correos electrónicos en un computador, en una red local y en unidades removibles (CD, DVD). Los documentos pueden ser buscados por palabras clave o utilizando un lenguaje de consulta, al igual que los motores de búsqueda de la Internet[1].

Principales características incluidas

§  “Búsqueda instantánea de textos completos de documentos o correos electrónicos.
§  Búsqueda contextual con morfología en 18 idiomas.
§  Soporte de Redes locales (LAN) y unidades removibles (CD, DVD y otras).
§  Soporte de formatos de archivo populares, búsqueda de documentos MS Office, PDF y TXT.
§  Búsqueda de documentos en ficheros ZIP, ACE, RAR y otros.
§  Búsqueda en mensajes de correo de Outlook, Outlook Express, MS Exchange, Netscape, PocoMail y The Bat! junto con sus archivos adjuntos.
§  Búsqueda remota y acceso de documentos vía Internet.
§  Soporte completo de codificación Unicote”[2].

INSTALACION DE LA HERRAMIENTA ARCHIVARIUS 3000

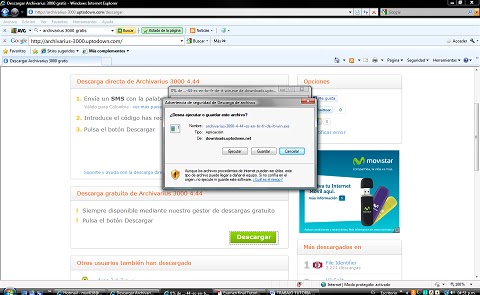
En Google se busca ARCHIVARIUS 3000 GRATIS y se da clik


Se escoge la opción descargar gratis dando clik


En el siguiente pantallazo se la opción descarga gratis


Aparece una ventana que pregunta si desea ejecutar el archivo


Se da clik en ejecutar, aparece un pantallaza para escoger el idioma y se le da Ok.


Aparece una opción que lo guía en la descarga del programa, ofrece Información que uptodown le garantiza la existencia del archivo y su seguridad, en Inicio y se le da la opción siguiente


En Componentes se le da la opción siguiente


Empieza a descargar


Aparece el asistente de instalación


El acuerdo de licencia


Acepto, siguiente e instalo y finalizar


Publicado por: Myriam Gil


[1] Archivarius 3000 Tecnologías Lingüísticas del Futuro. [en línea]. [Consultado: 01/10/11]. Disponible en: http://www.likasoft.com/es/document-search/
[2] Ibid [en línea].


miércoles, 19 de octubre de 2011

Sistemas de Información y Documentación, Archivística y Bibliotecología en la Universidad de la Salle


Con el firme propósito de preparar profesionales para que salgan al mundo a enfrentar la posibilidad de reducir todas las brechas posibles y existentes en el medio de la información, desde un tiempo atrás se ha venido motivando a los estudiantes a desarrollar prácticas que le permitan entender las necesidades del usuario de información y las diferentes formas de llegarle para obtener resultados efectivos y bien valorados acerca de los términos utilizados en la búsqueda o las popularmente llamadas palabras clave.


http://t0.gstatic.com/images?q=tbn:ANd9GcT5z3s6LWsvtr4ckIdltVjc_UwSXanvbkZaKgUHt6YaipL4jzX98w


Las prácticas consisten en conocer diferentes medios que facilitan la búsqueda de términos relevantes poniendo al estudiante en el rol de usuario activo, donde además de hallar la información, promueva el acceso a la misma. Para ello es necesario acceder a Blogger para crear un blog que de acuerdo al adecuado manejo y estructura general,  permita manejar el posicionamiento y el diseño de la información haciéndolo práctico y entendible a diferentes criterios de usuarios.


Se debe realizar un análisis de información que permita considerar resultados estructurados y que reflejen los niveles de relevancia o de importancia da cada una de las palabras que se han escogido para desarrollar la actividad.

La Universidad de la Salle ofrece los recursos físicos que permiten asociar la teoría con la práctica y conformar ecuaciones de búsqueda, que una vez utilizadas, constituyen un control útil para la demanda documental que hoy en día abarca para la institución ciertos niveles de importancia y genera posicionamiento y renombre para la construcción de un buen trabajo académico.

Publicado por:

http://t0.gstatic.com/images?q=tbn:ANd9GcT5z3s6LWsvtr4ckIdltVjc_UwSXanvbkZaKgUHt6YaipL4jzX98w

lunes, 17 de octubre de 2011

Fuentes de información en Recuperación de Información


Las revistas[1]
Actualmente son un medio muy práctico utilizado, ya que periódicamente ofrece información variable y actualizada sobre trabajos originales, revisiones, síntesis, congresos y reuniones de cualquier lugar del mundo. Además cada una de las publicaciones sobre un tema específico permite hacer un seguimiento a la evolución o trayectoria del mismo y así poder actualizar los conocimientos de una forma adecuada.

Revistas online de recuperación de información
Están dirigidas principalmente a profesionales y expertos en la búsqueda de información online con el fin de apoyar procesos investigativos, académicos y especializados. Algunos ejemplos de ellos serán relacionados a continuación y que desde el año 2008 hacia el presente han sobresalido en la web:

  •  En Econtent, antes llamado Database que comenzó a publicarse trimestralmente en septiembre de 1978 y pasó a ser bimestral en 1986. Además de artículos de investigación ofrece alternativas como análisis de noticias, productos, compañías, y columnas que analizan las últimas tendencias en la industria digital. La mayoría de sus autores son de Estados Unidos, sus columnas son relevantes a nivel internacional y ofrece los avances que se producen en la industria de contenidos digitales.
http://www.ecmag.net/Images/econtent1.gif
  • Information today, contiene noticias y desarrollos relacionados con la industria online, nuevas bases de datos, información de compañías, nuevos productos y servicios. Contiene secciones especiales sobre internet, bibliotecas, temas legales y propiedad intelectual. Es accesible electrónicamente desde octubre de 1998.
http://www.infotoday.com/pics/2006/logo.gif
  • Information World Review, publicada mensualmente y reconocida como una de las mejores fuentes de referencias y noticias sobre el mundo de la información online, haciendo especial énfasis en Europa y en Gran Bretaña. Contiene artículos, noticias, comentarios, recursos y personas de la industria online. Se publica desde 1974.
http://www.iwr.co.uk/_design/logo.png


Publicado por: Nubia Cortés


[1] Salvador Oliván, José A. Recuperación de la Información. Alfagrama ediciones. Capítulo 10.1ra edición, junio 2008. Argentina

miércoles, 12 de octubre de 2011

Review of Information Science (IS) perspectives

Autor: CHAN, Soon Keng; FOO, Schubert

Título: Interdisciplinary Perspectives on the Qualities of Abstracts for Information Retrieval.

Resumen[1]
“Eso permite a los escritores iniciados producir resúmenes para publicaciones o conferencias. Los resúmenes son un elemento importante para la recuperación de información. Es necesario que ambas disciplinas colaboren en investigaciones futuras”.

P. Clave
Resumen; calidad; recuperación de la información

“During the 60s and 70s, advanced technologies in information transfer methods have enabled a proliferation of information on the electronic information systems (Lorenz1969). Users were faced with problems of having to filter out constant streams of information inundating their systems, and the abstract, which is a 'mini' version of the full document, became a useful surrogate tool for quick and effective information retrieval. The 80s (Hills 1983) and 90s were landmarks that saw further technological advancements in high-speed computerization and later the Internet facilitated even more widespread and expedient information retrieval. Although information in full texts can now be efficiently retrieved and free text searching is possible, information experts like Pinto and Lancaster (1999) confirmed that abstracts are still useful and explained how full texts often contain details that cloud efficient identification of significant and precise information. Chowdhury, (1999) and Fidel (1986) added that availability of full-text and multimedia information in digital forms has increased the importance of the abstract in scholarly publications.

Consequently, information science writers paid great attention to producing guides to effective abstracting. They include writers who are experts on indexing and abstracting (Collision 1971; Borko and Bernier 1975; Rowley 1982; Cleveland and Cle veland 1983; and Lancaster 1991). Together they summed up the characteristics of a good abstract as one that has brevity, accuracy and clarity, but the over riding criterion of an abstract is whether it serves the needs of the users.

Other information professionals followed up with institutionalized standards, the most significant being American National Standard Institute commonly called ANSI Z39.14-1979, and International Standards ISO 214:1976. Such prolific literature on prescriptions for abstract writing belies the great concern of information professionals or experts in evaluating the quality of abstracts and on regulating the production of this surrogate.

A number of studies were conducted to assess readability using readability formulas, comprehension measures, or both. Dronberger and Kowitz (1975) suggested that the measurement of readability could provide an assessment of one phase of an information system. They explored abstracts published in Research in Education (RIE), and whose full documents were stored in Educational Resources Information Center (ERIC). Results showed that the reading level of abstracts was significantly higher than the reading level of source documents because of its concise nature and condensed information. However, it also showed that readability measurement does provide a useful technique for evaluating abstracts. Tenopir and Jacso (1993) measured the quality of abstracts based on style and readability, the extent to which the ANSI standard is observed, and exhaustivity of the abstract. They found that passive voice, prepositions, too many sentences per paragraph, too many words per sentence, and too many syllables per word all lowered readability. However, exhaustivity or extent of content coverage of source documents could not be so easily tested because of individual user needs.

In more recent studies, information professionals (Wheatley and Armstrong 1997) have conducted several major studies on abstract production for online services, a direction to which the ESP researcher may need to shift. Finally, Pinto and Lancaster (1999) based their study on judging the quality of authored abstracts in terms of exhaustivity, accuracy, readability, cohesion, brevity, and cost. They found that although the computer has enabled easy availability of full texts in electronic forms this has not reduced the value of human produced abstracts”.

Soporte: Archivo PDF Para mayor información consultar la página web:


Publisher for: Nubia Cortés


[1] CIBERABSTRACS. Directorio de recursos sobre el resumen. María Pinto. Consulta en línea: http://www.mariapinto.es/ciberabstracts/recumeta.php?pagina=2&criterio=recumeta